
当一篇论文不再只是被“阅读”,
而是被“安装”进 AI 智能体,知识的传播方式正在发生根本性变化。
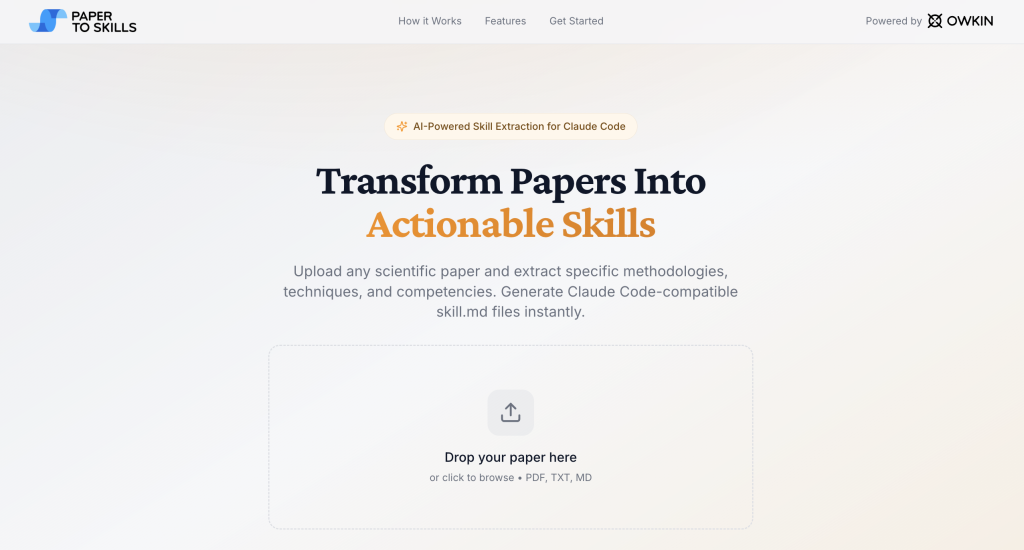
2026 年初,一个名为 Paper2Skills 的工具悄然上线。
它的核心功能简单却激进:
用户上传任何一篇科学论文,AI 自动提取其中的方法论、技术、工具和胜任力,生成可直接被 Claude Code 调用的 skill.md 文件。
这意味着什么?
过去,一篇论文的价值释放路径是:作者发表→ 被读者阅读→ 被理解 →被复现→ 被应用。
这个链条漫长、高损耗,且高度依赖读者的个人能力。
现在,路径正在被压缩为:发表→ 被提取→ 被安装→ 被调用。
与此同时,Paper2Agent 类工具(如 LobeHub 上的 paper-to-skill、SkillXiv 等)进一步将这一逻辑推向深入:
不仅提取技能,还生成可执行的代码、测试套件、部署脚本,甚至 Docker 容器。
这不仅仅是工具的效率提升。
这是一种知识生产方式的底层重构。
当论文不再只是“被阅读的知识”,而开始成为 Agent 可以调用的能力.
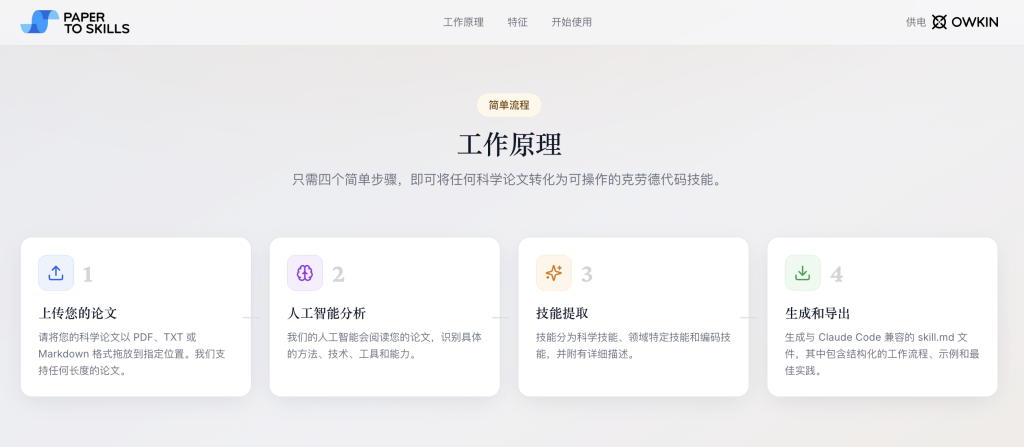
Paper2Skills产品流程是四步:
上传论文 → AI 全文分析 → 抽取技能并分三类 → 导出符合 Claude Code 规范的 skill.md。
论文的“可调用性”正在成为新的影响力指标。
过去,论文的影响力通过引用次数衡量。
未来,论文的影响力可能通过被多少智能体调用来衡量。
这意味着:论文作者需要思考:我的方法如何被提取为技能?如何被智能体调用?
期刊和会议可能需要提供“技能版本”的论文。
学术评价体系可能纳入“技能调用次数”作为指标。
更深层地,这改变了知识生产的目的。
过去,知识生产是为了“被理解”;未来,知识生产将同时为了“被调用”。
在过去,“论文发表之后如何传播”,这是出版伦理问题,是推广问题,是作者自觉的问题。
而现在,它变成了一个工程问题:给论文接上一个接口,让智能体能调用它。接口接好了,方法自然会被用起来。
这是知识形态的根本变化——从“被理解的知识”到“被调用的知识”,从“人类的知识”到“智能体的能力”。
尽管 Owkin 的验证结果令人鼓舞,
但是,不同领域、不同论文类型的准确性仍需大规模验证。
技能来源的安全风险不容小觑。
有研究对社区贡献的技能做过安全审计,结论是:26.1% 的社区技能包含漏洞。
不仅如此,论文技能的提取、分发、调用涉及版权和署名问题,而且自动化提取可能导致大量低质量技能涌入。
如果社区只是批量生成技能(SkillXiv 已经积累了 4064 个),而没有批量生成验证,那么,技能库会迅速膨胀成一个体量巨大、参差不齐、缺乏可信度分级的知识池。
这对新手尤其危险:他可能安装一个语法完整、逻辑错误的技能,然后,基于它做出错误结论。不仅如此,过度依赖技能调用可能削弱深度理解能力等等。
展望未来,当一篇论文可以被“安装”进智能体,学术知识的传播和应用方式正在被重新定义。
今天,而这一切,才刚刚开始。
对此,您怎么看?
欢迎跟帖分享您的主张!
访问学者期末总结汇报 Photo by Johnnie Walker